Bagi sebagian pustakawan, terutama yang sudah bertahun-tahun bekerja dengan kartu katalog dan format MARC klasik, mendengar kata “RDA” bisa jadi sedikit membuat gentar. Padahal perubahan ini bukan sekadar ganti istilah atau format baru yang dipaksakan dari luar — ada alasan struktural yang cukup mendasar di baliknya, dan begitu dipahami, transisi ini justru terasa masuk akal.
Era Baru Deskripsi Bibliografi di Lingkungan Digital
AACR2 (Anglo-American Cataloguing Rules, edisi kedua) lahir di masa ketika materi cetak masih menjadi format dominan di perpustakaan. Aturan-aturannya dirancang dengan asumsi katalogisator sedang memegang buku fisik di tangan, mencatat detail fisiknya satu per satu — jumlah halaman, ukuran, jenis jilid. Untuk konteks itu, AACR2 bekerja dengan sangat baik.
Masalahnya muncul begitu koleksi perpustakaan mulai diisi e-book, database daring, rekaman audio digital, hingga sumber daring yang sifatnya berubah-ubah. AACR2 tidak pernah dirancang untuk mengakomodasi keragaman format sebesar ini, sehingga pustakawan sering harus “memaksakan” aturan lama ke format baru — hasilnya deskripsi bibliografis yang janggal atau bahkan tidak konsisten antar institusi.
Di sinilah RDA (Resource Description and Access) masuk. Bukan sebagai pembaruan kosmetik, tapi sebagai standar yang memang dibangun untuk lingkungan digital sejak awal. Yang membuatnya semakin relevan, RDA dirancang agar data katalog bisa “berbicara” dengan sistem pencarian berbasis web — sesuatu yang praktis mustahil dilakukan AACR2 tanpa modifikasi besar-besaran. Bagi perpustakaan yang ingin koleksinya tetap bisa ditemukan di tengah dominasi mesin pencari dan katalog daring lintas institusi, migrasi ke RDA bukan lagi wacana jangka panjang, melainkan kebutuhan yang mendesak.
Memahami Pondasi FRBR pada Standar Baru
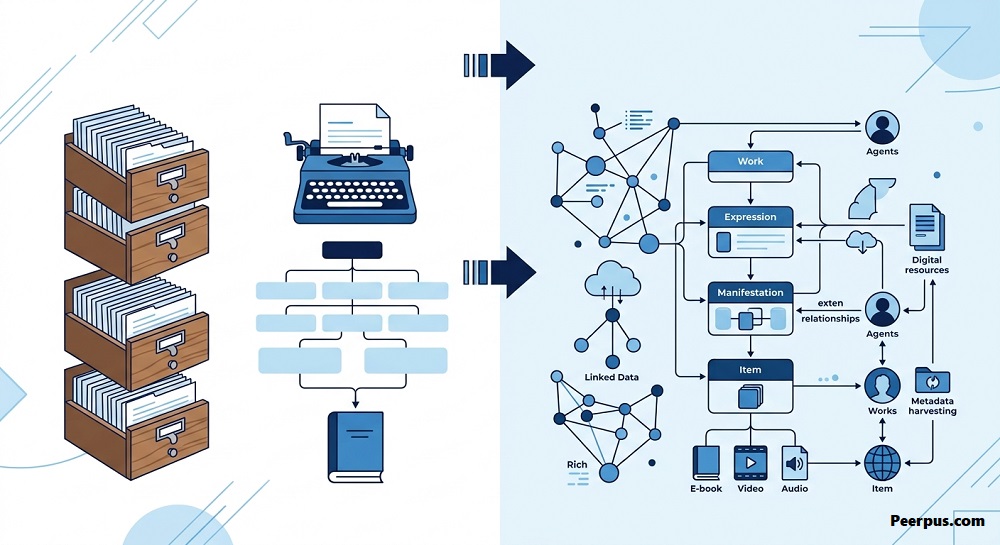
Kalau AACR2 memperlakukan setiap item sebagai satu catatan tunggal, RDA berangkat dari model konseptual yang disebut FRBR (Functional Requirements for Bibliographic Records). Model ini memecah sebuah karya menjadi empat lapisan entitas yang saling berkaitan: Karya (Work), Ekspresi (Expression), Manifestasi (Manifestation), dan Item.
Penjelasan singkatnya begini. Karya adalah gagasan abstrak di balik sebuah judul — misalnya novel “Laskar Pelangi” sebagai ide dan cerita itu sendiri. Ekspresi adalah realisasi dari gagasan itu, entah dalam bentuk teks bahasa Indonesia atau versi terjemahan bahasa Inggrisnya. Manifestasi adalah wujud fisik atau digital dari ekspresi tersebut, seperti edisi cetak tahun 2005 terbitan Bentang Pustaka, atau versi e-book-nya. Item adalah satu eksemplar spesifik yang ada di rak perpustakaan Anda, lengkap dengan nomor inventarisnya.
Pemisahan berlapis ini kelihatan rumit di atas kertas, tapi manfaatnya langsung terasa saat pengguna mencari. Bayangkan seorang mahasiswa mencari “Laskar Pelangi” di katalog daring perpustakaan. Dengan struktur FRBR, sistem bisa menampilkan satu entri utama untuk karya tersebut, lalu mengelompokkan semua variasinya di bawahnya — edisi cetak, e-book, versi audio, bahkan terjemahan — dalam satu tampilan yang rapi. Dibandingkan katalog lama yang menampilkan belasan entri terpisah untuk judul yang sama, pengalaman pencarian jadi jauh lebih masuk akal bagi pengguna yang mungkin tidak paham istilah katalogisasi sama sekali.
Perubahan Teknis Pencatatan Data Katalog
Salah satu prinsip paling mencolok dalam RDA adalah “take what you see” — tulis apa yang benar-benar tertera pada sumber, bukan menerjemahkan atau menyingkatnya sesuai konvensi Latin yang selama ini dipakai. Praktik lama seperti menuliskan [s.l.] untuk “sine loco” (tanpa tempat terbit) atau [s.n.] untuk “sine nomine” (tanpa nama penerbit) kini ditinggalkan. Singkatan-singkatan semacam itu memang efisien bagi pustakawan yang paham bahasa Latin, tapi bagi pengguna awam justru terasa seperti kode rahasia yang tidak menjelaskan apa-apa. RDA menggantinya dengan frasa yang jelas dalam bahasa yang dipakai, seperti “tempat tidak diketahui” atau “penerbit tidak teridentifikasi”.
Perubahan yang lebih terasa dampaknya justru ada di level struktur data MARC. Selama ini field 245 subfield $h menampung GMD (General Material Designation) — semacam label umum yang menjelaskan jenis materi, seperti [rekaman suara] atau [sumber elektronik], yang ditempel langsung di judul. Pendekatan ini sebenarnya cukup kaku, karena satu label harus mewakili banyak informasi sekaligus.
RDA memecah informasi ini menjadi tiga field baru yang lebih spesifik: field 336 untuk tipe konten (misalnya teks, gambar bergerak, atau musik terekam), field 337 untuk tipe media (seperti media komputer atau audio), dan field 338 untuk tipe wadah (seperti online resource atau videodisc). Pemisahan ini terdengar seperti detail teknis yang remeh, tapi dampaknya cukup besar pada fleksibilitas sistem — mesin pencari dan sistem temu kembali bisa memfilter koleksi berdasarkan kombinasi ketiga aspek ini secara jauh lebih presisi dibanding hanya mengandalkan satu label GMD yang serba umum.
Strategi Adaptasi Pustakawan Menghadapi Migrasi Data
Di lapangan, tantangan terbesar migrasi ke RDA jarang soal memahami konsepnya — kebanyakan pustakawan bisa mengikuti pelatihan dan memahami logika di baliknya dalam waktu relatif singkat. Yang jauh lebih berat adalah proses migrasi data itu sendiri: ribuan, bahkan puluhan ribu, catatan bibliografis lama yang masih mengikuti struktur AACR2 harus disesuaikan, baik lewat konversi otomatis maupun penyuntingan manual untuk kasus-kasus yang tidak bisa dipetakan langsung oleh sistem.
Belum lagi urusan pelatihan ulang staf, penyesuaian SOP internal, dan kadang harus bernegosiasi dengan vendor sistem otomasi perpustakaan yang dipakai institusi. Proses ini bisa memakan waktu berbulan-bulan tergantung ukuran koleksi, dan wajar kalau banyak pustakawan awalnya melihatnya sebagai beban tambahan di tengah pekerjaan harian yang sudah padat.
Namun ada baiknya migrasi ini dilihat bukan sebagai proyek administratif semata, melainkan investasi jangka panjang menuju ekosistem Linked Data. Struktur RDA yang lebih granular dan berbasis entitas membuat data katalog perpustakaan jauh lebih mudah “dibaca” oleh sistem lain, termasuk mesin pencari global. Dengan kata lain, koleksi yang selama ini hanya bisa ditemukan lewat OPAC internal, berpotensi lebih mudah muncul dan terhubung ke jaringan data yang lebih luas — sesuatu yang sejalan dengan arah perkembangan perpustakaan digital ke depan, di mana visibilitas koleksi tidak lagi dibatasi tembok katalog lokal.